在浏览器中清理 PDF 文档信息
文件不会离开你的设备。 通过 pdf-lib 清理 PDF Info 字典 · 最多 10 个文件。不声称清除全部嵌入 XMP/追踪流。
或拖放到此处
是什么
清洗 PDF 元数据时具体会清空哪些文档属性
每一份标准 PDF 文件都在尾部携带一个文档信息字典(Document Information Dictionary,即 `/Info`),用于记录独立于正文排版之外的管理属性。使用本工具在浏览器本地清洗 PDF 元数据时,pdf-lib 管线会清空标准 `/Info` 字典中的核心键值——包括作者(Author)、标题(Title)、主题(Subject)、关键词(Keywords)、创建应用程序(Creator)、PDF 转换引擎(Producer)、创建日期(CreationDate)与修改日期(ModDate)。由于全流程在本地浏览器内存中完成,涉及商业机密、法律协议或未发表科研成果的 PDF 绝不会离开你的设备。
- 在浏览器本地清洗 PDF 元数据,清空标准 `/Info` 文档信息字典
- 清除作者(Author)、标题(Title)、主题(Subject)与关键词(Keywords)字段
- 剥离创建程序(Creator)、转换引擎(Producer)及创建/修改时间戳
- 基于本地 pdf-lib 处理,不将文字转曲或栅格化,完整保留正文清晰度与可搜索性
- 免费支持单次最多 10 个 PDF 文档批量清洗并一键下载本地 ZIP 压缩包
- 诚实边界:清理标准 `/Info` 字典字段,不声称抹除全部深层 XMP 流或替代正文涂黑脱敏
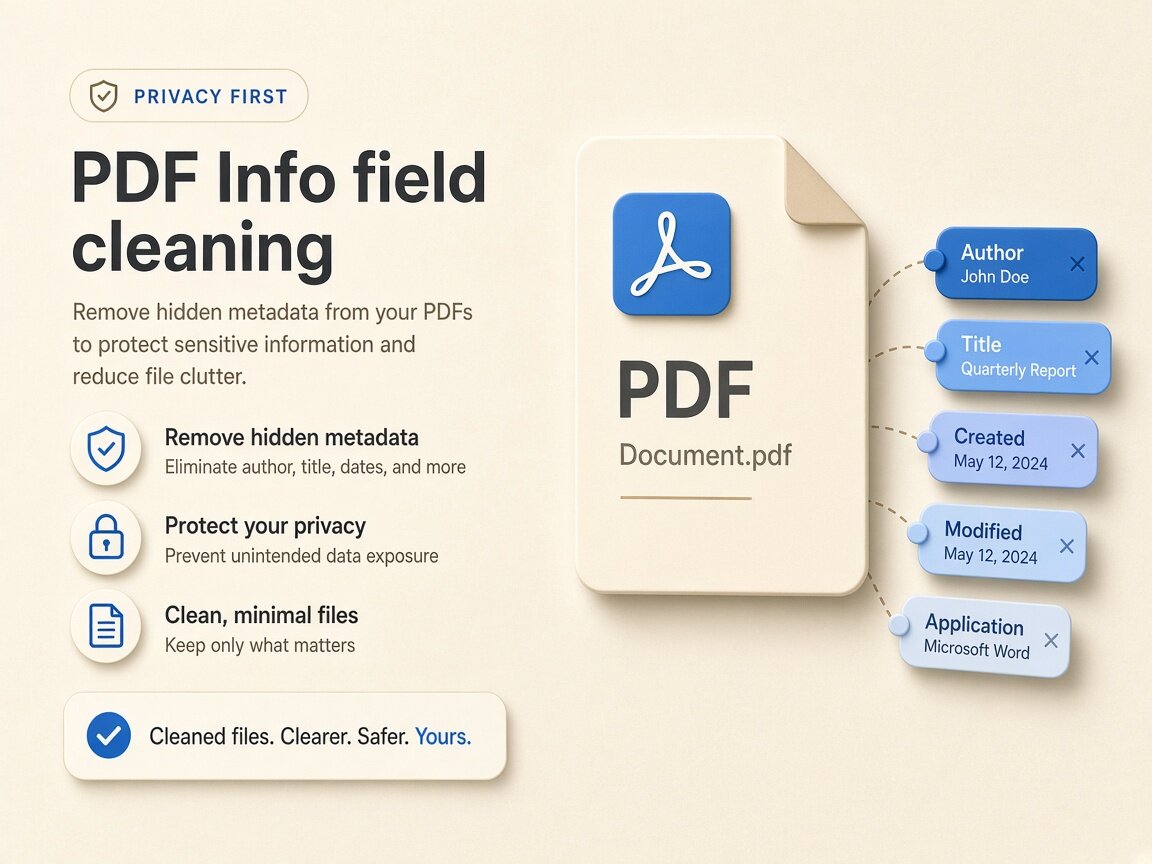
Info 字典解析
深入解析:为什么导出的 PDF 属性里会残留内部草稿名与员工账号
当你从 Microsoft Word、Google Docs 或排版软件导出 PDF 时,系统不仅会把当前登录的操作系统账号写入 `/Author`,还常把源文件的旧名称(例如 `报价单_底价版_v3.docx`)自动填入 `/Title` 字段,并把操作系统与办公软件版本写入 `/Creator` 和 `/Producer`。收件人只需在阅读器中按下 Ctrl+D(或 Cmd+D)打开「文档属性」,这些隐藏信息便一览无余。通过本工具在本地浏览器清洗 PDF 元数据,可以在保持正文文字、矢量图表与超链接丝毫无损的前提下,将这些 `/Info` 属性彻底重置。
- 清空 `/Author` 字段中自动带出的个人电脑用户名或前同事姓名
- 抹除 `/Title` 与 `/Subject` 中残留的内部模板文件名或草稿备注
- 移除 `/Creator` 与 `/Producer` 中记录的排版软件、操作系统与转换驱动标识
- 重置 `/CreationDate` 与 `/ModDate` 时间戳,避免暴露文档实际起草时间
诚实能力边界
明确区分 `/Info` 字典清理与深度流级脱敏 / 正文涂黑
处理办公与法律文档时,准确理解工具的技术边界至关重要。本工具使用轻量高效的 pdf-lib 在浏览器本地清理标准 `/Info` 文档信息字典(即主流阅读器「属性」窗口展示的字段)。我们坦诚说明:该流程并不声称会递归清除 PDF 内部所有自定义对象级 XMP 数据流、表单脚本或字体子集标记;同时,清理元数据绝不等于「正文密文涂黑(Redaction)」——如果你在页面正文中用黑色矩形框盖住了敏感身份证号或金额,底层文字依然可以被复制出来,请务必在源文档中直接删除敏感文字后再导出并清洗 PDF 元数据。
- 清理 Acrobat、macOS 预览与浏览器阅读器「文档属性」中展示的标准 Info 字段
- 不声称清除全部深层内嵌的自定义 XMP 元数据流或文档对象级追踪块
- 不能替代针对页面正文敏感文字的物理删除或专业密文脱敏(Redaction)
- 如 PDF 内插有带定位的手机照片,建议先在「图片」页签洗净照片后再排版导出
为什么
为什么选择在浏览器本地清洗 PDF 元数据
机密文档不出本机,严守合规底线
将保密协议(NDA)、财务报表、未发表论文或个人简历上传到免费在线 PDF 网站存在极高泄露隐患。本工具完全在浏览器本地内存内清洗 PDF 元数据,文件绝不上传服务器。
保持矢量文字、字体与排版 100% 原样
通过 pdf-lib 直接更新文档字典结构,不会把页面栅格化为模糊图片,正文文字依然可复制、可搜索,体积也不会膨胀。
诚实透明说明 `/Info` 清理范围
我们清楚界定标准 `/Info` 字典清理与深层 XMP 流/正文脱敏的区别,绝不用夸大宣传误导有严格合规要求的用户。
最多 10 份文档免费批量处理与 ZIP 下载
无需注册账号,一次可拖入最多 10 份 PDF 文件,几秒内完成本地批量清洗,并支持逐个保存或一键打包下载 ZIP。
怎么做
如何在浏览器中分四步清洗 PDF 元数据
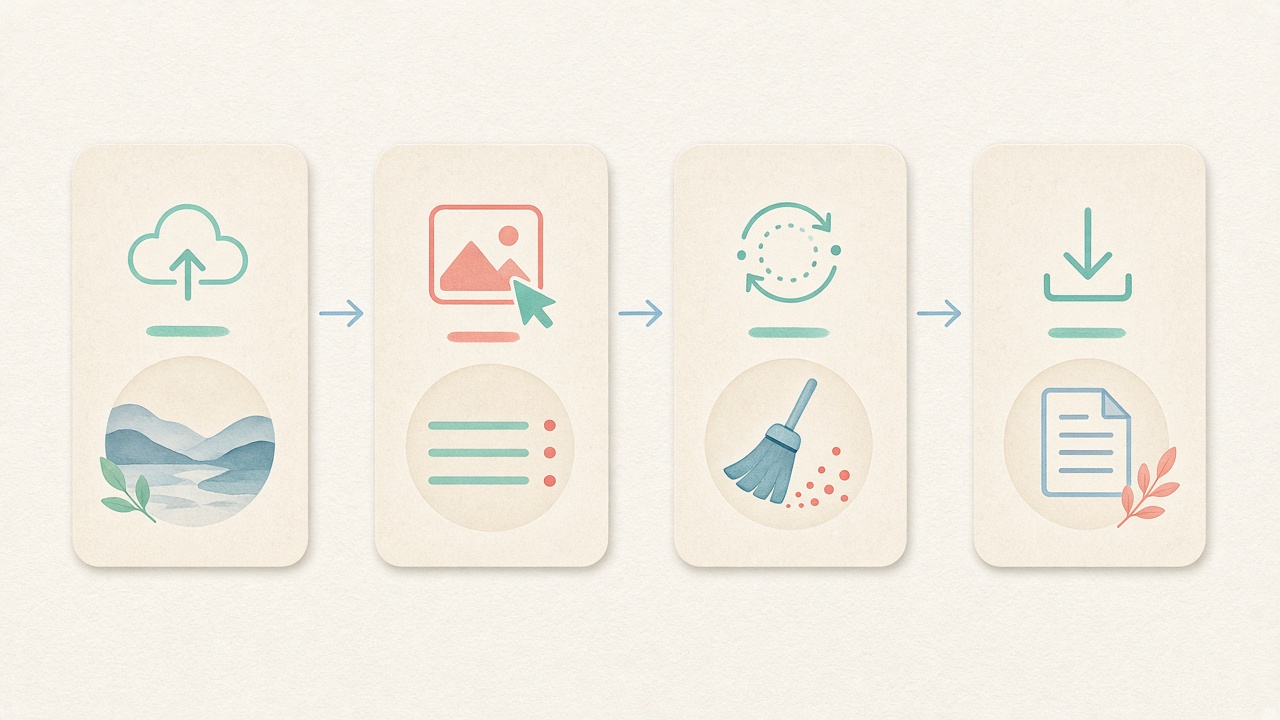
- 步骤 1
直接使用本页默认展开的 PDF 页签
进入本页后上方工作区已自动切换到「PDF」页签,无需登录即可直接开始。
- 步骤 2
拖入最多 10 份 PDF 文档
将合同、简历、论文或报告拖入队列,在本地查看当前检出的文档 Info 字段。
- 步骤 3
执行本地 pdf-lib 属性清理
点击清洗按钮,浏览器会在本地内存中清空标准 `/Info` 字典字段,同时保留页面正文排版。
- 步骤 4
保存干净 PDF 或打包下载 ZIP
逐份下载或一键保存为单个 ZIP 压缩包;需要复核时可拖入只读「检测(Detect)」页查看。
场景
哪些场景最需要在发送前清洗 PDF 元数据
学术期刊与会议双盲审稿(Double-Blind Review)
双盲审稿要求隐去作者与机构信息,但 Word 与 LaTeX 导出的 PDF 常在 Author 字段留下真名。投稿前在本地一键清空最稳妥。
求职者投递个人简历与作品集
复用旧简历模板导出 PDF 时,文档属性里往往残留着旧标题或他人用户名。投递前洗净属性可展现严谨职业细节。
咨询公司、律所与商务提案团队
向客户发送方案书或报价单时,不应让对方从 PDF 属性中看到「某客户模板修改版」等内部源文件名。
企业法务、HR 与行政公文发布
对外发布规章制度、通知公告或账单发票前,在浏览器本地统一清除经办人电脑账号与修订时间记录。
数字商品卖家与电子书/手账创作者
在 Etsy 或独立站售卖 PDF 电子手账、图纸与教程时,先批量清除个人电脑作者名与排版软件标识。
机构信息公开与日常文档脱敏
将内部汇报材料转化为公开网页附件前,通过浏览器快速完成标准 `/Info` 属性清理,无需安装昂贵的专业版 Acrobat。
用户声音
用户怎么说
示意性示例,仅用于版式展示——非已验证客户评价,无星级评分。
Maya R.
产品摄影师
“客户图库上线前必须去掉 GPS。本地批量 + ZIP 正是我想要的。”
Jordan K.
Etsy 卖家
“手机照片带家庭坐标。在浏览器清洗,就不用把原图上传到陌生网站。”
Alex T.
社交设计师
“对 C2PA 容器与 SynthID 的边界说得很清楚。我先 Detect 再 Clean,没有夸大承诺。”
Sam L.
自由编辑
“默认开启指纹防护,降低反向搜图风险;像素必须精确时我再关掉。”
Riley P.
内容创作者
“视频和 PDF 也能本地清,不用为三种格式开三个账号。”
Casey M.
电商运营
“上架前批量清 GPS 成了固定流程。免费额度对小团队够用。”
相关
相关指南与工具
常见问题
关于清洗 PDF 元数据的常见问题(FAQ)
- 我可以不上传文件就在浏览器本地清洗 PDF 元数据吗?
- 完全可以。本页面加载完成后,所有的 PDF 解析与文档属性更新都通过 pdf-lib 在你当前浏览器的本地内存中执行。你的合同、简历、财务报表或学术论文绝不会上传到我们的服务器,也不会保存在任何外部云端,彻底杜绝机密文档外泄。
- 清洗 PDF 元数据时,具体会清空哪些字段?
- 工具会清空标准 PDF 文档信息字典(Document Information Dictionary,即 `/Info`)中的核心属性,包括作者(Author)、标题(Title)、主题(Subject)、关键词(Keywords)、创建程序(Creator)、PDF 生成引擎(Producer)、创建日期(CreationDate)以及修改日期(ModDate)。这些正是收件人在阅读器里打开「文档属性」时看到的内容。
- 本工具会清除 PDF 里所有的深层 XMP 数据流或隐藏涂层文字吗?
- 不会,我们坚持提前如实说明这一边界:本工具基于 pdf-lib 清理标准 `/Info` 字典字段,并不声称能抹除所有自定义的深层对象级 XMP 数据流、嵌入附件或表单脚本。此外,清理元数据不能替代正文脱敏——如果你只是在正文中用黑色色块遮盖了敏感文字,底层文字仍可被复制,请务必在排版源文件中直接删除敏感文字。
- 清洗 PDF 元数据会改变文档的字体、排版、超链接或文字可搜索性吗?
- 完全不会。pdf-lib 仅在文件结构层面更新 `/Info` 字典条目,不会重新渲染页面内容,也不会将文字栅格化为图片。你的字体样式、矢量图表、目录书签、可点击链接以及可复制/可搜索的正文文本都会 100% 保持原样。
- 为什么学术论文投稿(双盲审稿)前必须清洗 PDF 元数据?
- 在实行双盲审稿(Double-Blind Peer Review)的学术会议与期刊中,审稿人不得知晓作者身份。许多学者虽然删掉了论文首页的署名,但从 Word 或 LaTeX 导出 PDF 时,系统仍会自动把作者姓名、实验室名称或 TeX 路径写入 `/Author` 与 `/Creator` 属性中,导致因违反匿名原则被直接拒稿。投稿前在本地清洗并复核即可避免这一失误。
- 如果 PDF 里面插有手机拍的照片,清洗 PDF 元数据能顺便去掉照片里的 GPS 吗?
- 不能。清理 PDF 的 `/Info` 文档字典不会深入改写页面内部已嵌入 JPEG 图像流的私有 EXIF/GPS 字节。如果你的文档中需要插入包含敏感定位或相机信息的照片,建议先使用本站的「图片(Images)」页签将照片清洗干净,再插入到 Word 或排版软件中导出 PDF。
- 免费版单次可以批量清洗多少个 PDF 文件的元数据?
- 无需注册或登录,你每次最多可以向 PDF 工作区拖入 10 个 PDF 文档进行批量处理。本地处理完成后,既可以逐个点击下载,也可以一键打包下载为单个 ZIP 压缩包;若有更多文档,分批拖入即可免费继续使用。
- 清洗完成后,如何验证导出的 PDF 已经没有作者和源文件名信息?
- 保存清洗后的 PDF 副本后,你可以点击页面上的「检测(Detect)」模式,把新文件拖进去做一次本地只读检查;或者直接在本地电脑上用 Adobe Acrobat、macOS 预览或 Chrome/Edge 浏览器打开该 PDF 并按下 Ctrl+D / Cmd+D 查看「文档属性」,即可确认作者、标题与创建程序字段均已清空。
本工具仅处理你本地持有的文件副本。清洗 PDF 元数据通过本地 pdf-lib 清空标准 PDF Info 字典字段,不声称移除所有深层嵌入的 XMP/追踪流,也不能替代针对页面正文敏感文字的物理脱敏。